Antes de empezar: qué es oficial y qué es mío
Esta guía mezcla dos cosas que no deben confundirse:
- Documentación oficial de OpenAI: qué son Chat, Work y Codex; cómo describe OpenAI sus modelos; qué implica subir el esfuerzo; y qué factores consumen más tokens o créditos.
- Mi sistema de trabajo: cómo traduzco esas capacidades a proyectos reales de negocio, contenido, documentación, diseño, vídeo, automatización y producto.
Para que nadie tenga que creerme por fe, usaré estas etiquetas:
- [OFICIAL] Información respaldada por documentación pública de OpenAI.
- [MÉTODO MILI] Decisión práctica que utilizo en mi trabajo. Puede ser muy útil sin ser una regla universal de OpenAI.
- [CASO REAL] Ejemplo extraído de proyectos o conversaciones reales. Los datos sensibles se eliminan o generalizan.
- [VARIABLE] Algo que depende del plan, la cuenta, el despliegue, el cliente o la configuración y debe comprobarse en la interfaz actual.
No voy a publicar conversaciones internas completas, credenciales, nombres de empleados, información de clientes ni detalles de infraestructura. Enseñar desde el barro no significa tirar la confidencialidad por la ventana.
La idea central: no necesitas siempre el modelo más potente
Durante mucho tiempo hemos cometido con la IA el mismo error que con el software: comprar potencia antes de definir el problema.
La pregunta no es: «¿Cuál es el modelo más bestia?»
La pregunta correcta es:
¿Qué resultado necesito, dónde debe vivir, qué riesgo tiene y cuál es la opción menos costosa que puede hacerlo bien?
Esta guía se sostiene sobre cuatro decisiones distintas:
- Superficie: Chat, Work o Codex.
- Modelo: Luna, Terra, Sol o Astra, cuando estén disponibles.
- Esfuerzo: Light/Low, Medium, High, Extra High, Max o Ultra, según la superficie y la cuenta.
- Contexto y herramientas: fuentes, archivos, aplicaciones, navegador, terminal, repositorio y criterios de validación.
Si mezclas estas cuatro capas, acabas subiendo el modelo para compensar una instrucción mala, usando Work para una frase de tres líneas o metiendo todo el repositorio cuando solo había que tocar un HTML.
Parte I. Elegir dónde trabajar
1. Chat: cuando necesitas una buena respuesta
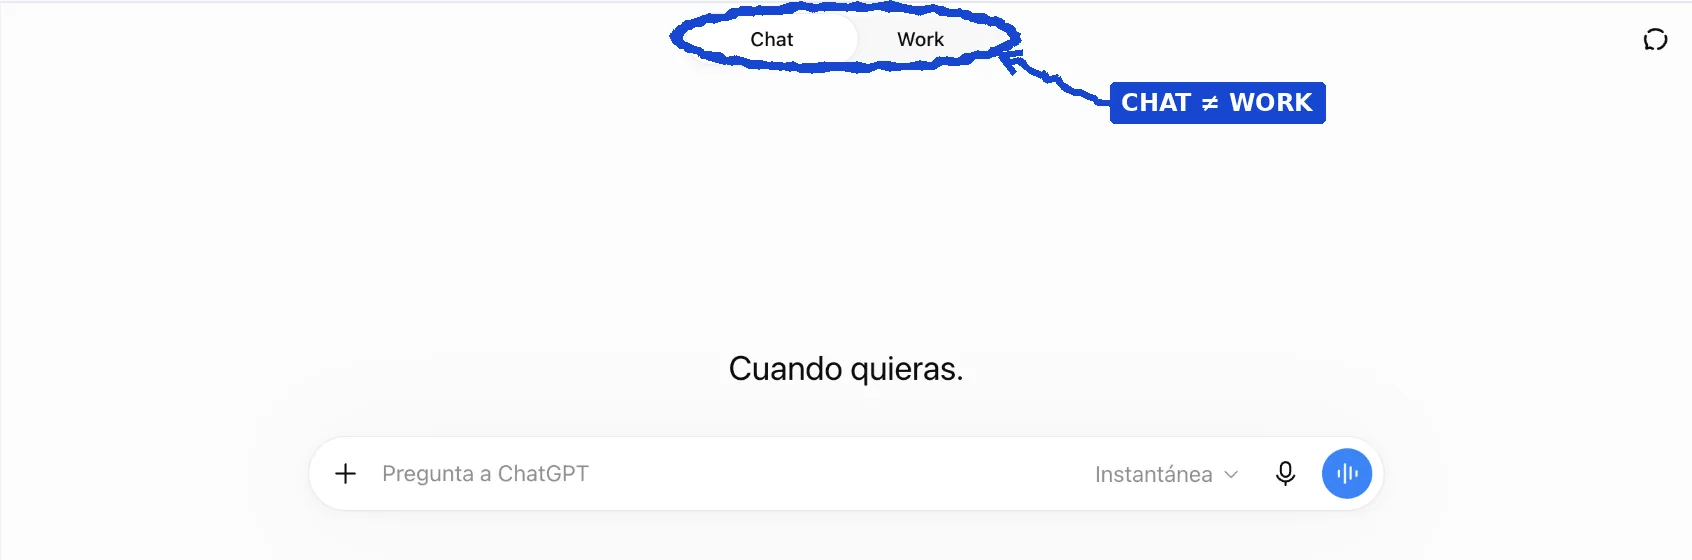
La misma cuenta permite cambiar de una conversación normal a un entorno de ejecución. El selector real evita confundir la superficie de trabajo con el modelo.
Lo uso para
- Resolver una duda concreta.
- Pensar en voz alta.
- Preparar un comentario de LinkedIn.
- Pulir un hook, un párrafo o un correo.
- Comparar dos enfoques sin producir todavía un archivo final.
- Decidir el siguiente paso de un proyecto.
No lo convierto en Work por inercia
Si solo quiero saber si un titular funciona, no necesito abrir un proyecto, adjuntar ocho documentos y pedir una auditoría. Chat es suficiente si la conversación contiene el contexto que cambia la respuesta.
Ejemplo real
[CASO REAL] LinkedIn. Cuando tengo la idea, el post al que respondo y el ángulo que quiero defender, Chat sirve para redactar y afinar. La validación no es «suena profesional». Es: ¿lo diría yo en voz alta?
2. Work: cuando necesitas que el trabajo termine en algo utilizable
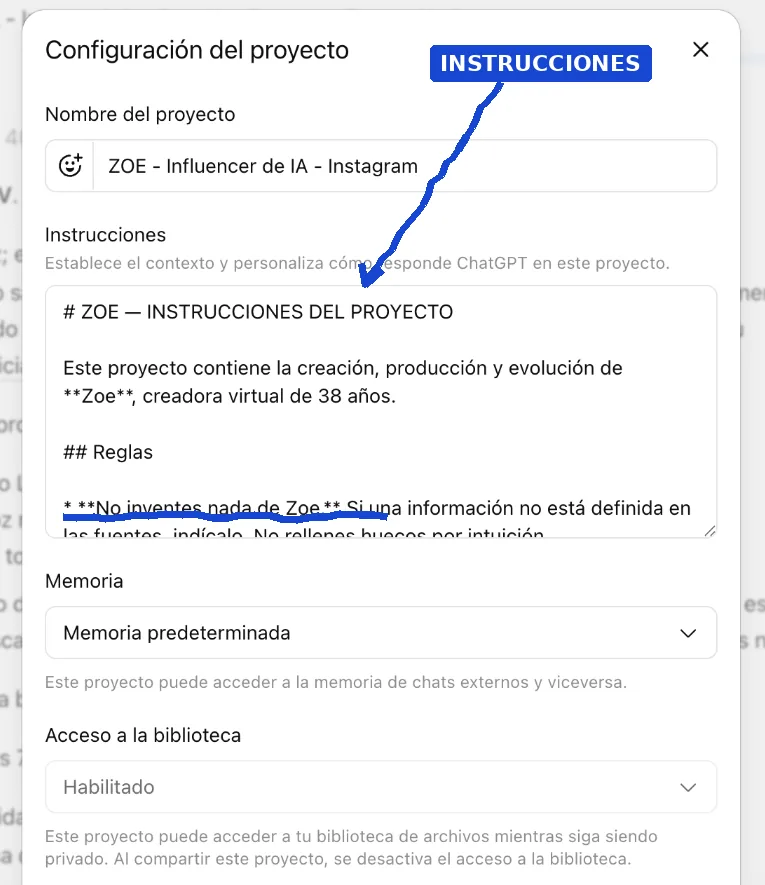
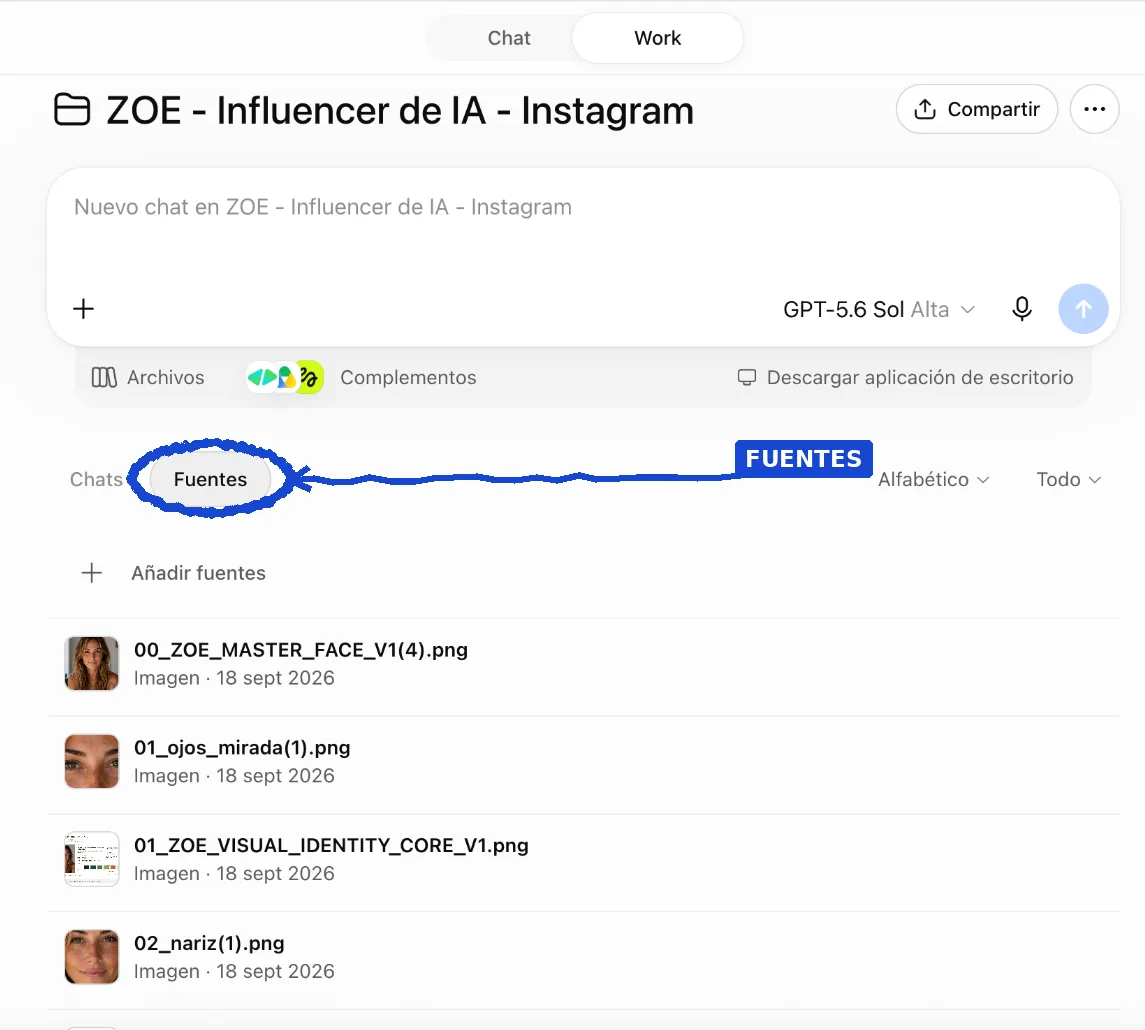
Un proyecto no se vuelve útil por ponerle nombre: necesita reglas y fuentes de verdad. El proyecto Zoe muestra las instrucciones y los archivos que sostienen el trabajo.
Lo uso para
- Investigación con fuentes actuales.
- Documentos largos y entregables.
- PDFs, presentaciones, hojas de cálculo e imágenes.
- Proyectos que necesitan continuidad.
- Análisis de varias fuentes o archivos.
- Trabajo conectado con aplicaciones y servicios.
- Tareas de varias fases que debo revisar antes de aprobar.
Work local o Work cloud
Ejemplo real
[CASO REAL] Marco de numeración 400 para Netelip. No era «escribe un artículo». Primero había que leer fuentes legales y regulatorias, separar llamadas comerciales de otros usos, registrar dudas operativas y producir una fuente interna que después pudiera alimentar blog, centro de ayuda y materiales para clientes. Eso es Work: varias fuentes, consecuencias reales y un documento que otras personas van a utilizar.
Lo que no se pudo verificar —precio, tratamiento de cuotas anuales, migración técnica o declaración de uso— quedó señalado como pendiente. Una buena guía no rellena huecos con prosa convincente.
3. Codex: cuando el resultado vive dentro de archivos, código o un entorno técnico
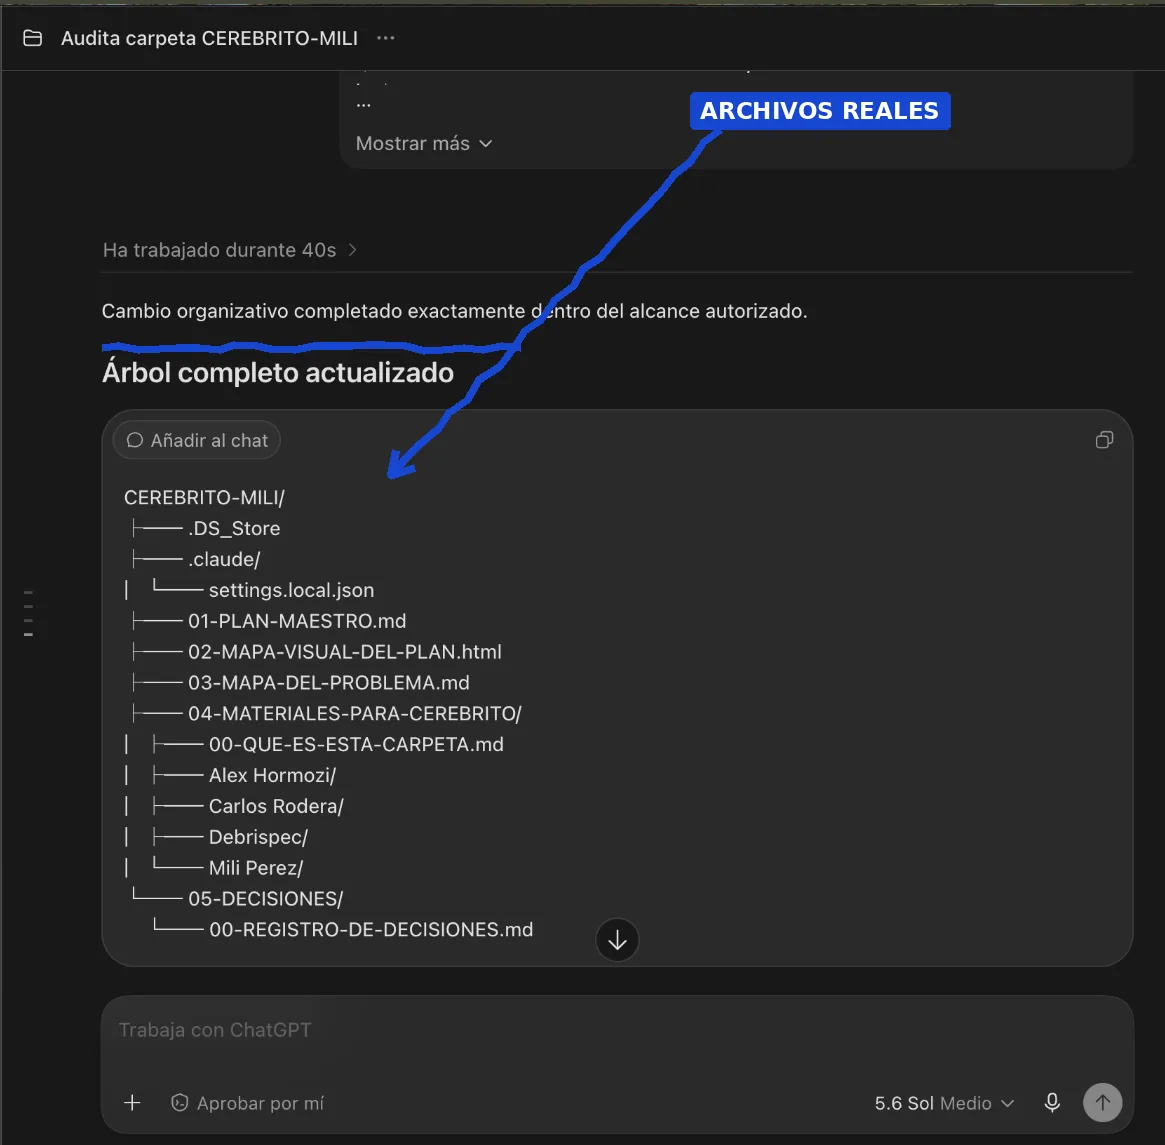
El trabajo vive en una estructura comprobable, con materiales, decisiones y archivos. La captura conserva el árbol real de CEREBRITO-MILI y elimina la navegación que no aporta.
Codex no es «ChatGPT, pero para programadores». Su diferencia práctica es que puede trabajar de forma operativa sobre proyectos, archivos y entornos de desarrollo, ejecutar comandos, revisar cambios y comprobar resultados.
Lo uso para
- Editar HTML, CSS, JavaScript o cualquier código real.
- Revisar un repositorio sin modificarlo.
- Ejecutar pruebas, linters y validaciones.
- Hacer cambios acotados y revisar el diff.
- Crear o mantener scripts y automatizaciones.
- Investigar errores que dependen de varios archivos.
- Trabajar con configuraciones, integraciones, APIs o despliegues.
Ejemplo real
[CASO REAL] Firma de correo HTML. La estructura, el contenido y la intención se pueden decidir en Work. Cuando toca editar los archivos, comprobar enlaces, revisar el HTML y validar que no hemos roto otra parte, entra Codex. En una decisión anterior elegimos Codex local + Terra + esfuerzo medio para las ediciones y las comprobaciones; Sol quedaba reservado para una revisión difícil, no para cambiar cada línea.
Otro ejemplo real
[CASO REAL] Auditoría de CEREBRITO-MILI. La primera fase fue de solo lectura: nada de crear, borrar, mover o renombrar archivos. La orden operativa importaba más que el modelo. Codex auditó el proyecto y la fase de implementación quedó sin iniciar. Después, un cambio concreto —renombrar una referencia— se trató como una operación separada y acotada.
La tabla que evita el 80 % de las dudas
| Si necesitas… | Empieza en… | Porque… | Salta a otro entorno cuando… |
|---|---|---|---|
| Una respuesta, explicación o texto corto | Chat | El valor está en la conversación | Necesitas archivos, herramientas o un entregable complejo |
| Investigación, análisis o documento final | Work | El valor está en completar y revisar el trabajo | Hay que modificar código o ejecutar comprobaciones técnicas |
| Editar archivos técnicos, repositorios o automatizaciones | Codex | El valor está en actuar y verificar | Necesitas volver a presentar el resultado como documento o pieza editorial |
| Definir una integración | Work | Primero hay que entender negocio, datos, permisos y errores | Empieza la implementación o las pruebas sobre archivos reales |
| Maquetar un documento aprobado | Work | Ya existe una fuente maestra y toca producir el entregable | Hace falta construir una plantilla o herramienta por código |
- ¿Cabe en una conversación? Chat.
- ¿Debe terminar en un entregable revisable? Work.
- ¿Vive en archivos, código o pruebas? Codex.
No es una frontera perfecta. Es una forma de empezar sin gastar media hora decidiendo.
Parte II. Elegir modelo sin tirar créditos
Luna, Terra, Sol y Astra: lo que OpenAI dice hoy
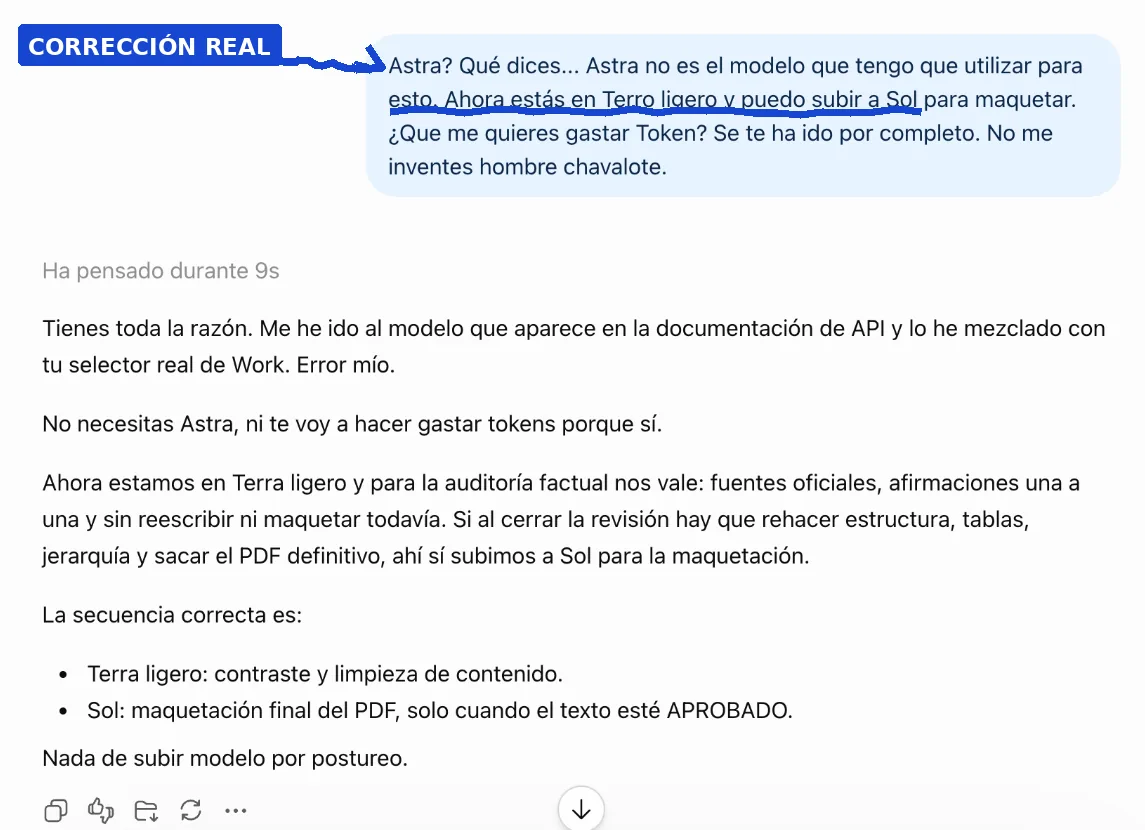
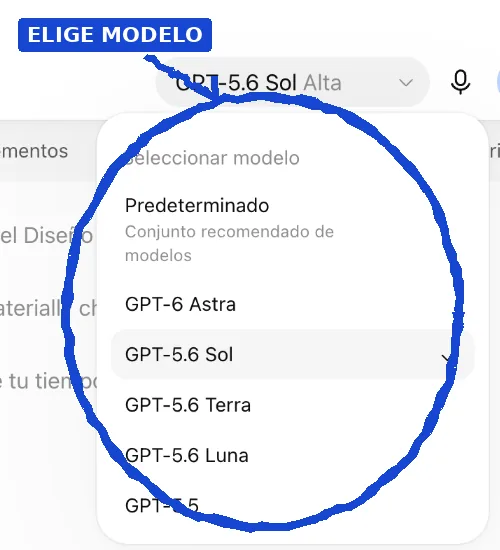
El selector muestra los modelos disponibles ese día. La conversación demuestra que el modelo más capaz no era el adecuado: Terra ligero bastaba para contrastar y Sol quedaba para la maquetación.
Esta parte corrige una afirmación del borrador anterior. Antes tratábamos Terra, Luna y Sol como etiquetas sin equivalencia pública confirmada. Ya no es correcto: OpenAI los documenta expresamente.
| Modelo | Descripción oficial resumida | Punto de partida práctico |
|---|---|---|
| Luna 5.6 | Modelo rápido y asequible; el de menor coste de la familia. Recomendado para tareas claras, específicas, repetibles y de volumen, como extracción, clasificación, transformación y resúmenes estructurados. | Cuando sé exactamente qué entra, qué sale y cómo validar el resultado. |
| Terra 5.6 | Modelo equilibrado para el trabajo cotidiano; el «todoterreno pragmático». | Mi salida por defecto para trabajo normal con razonamiento y herramientas. |
| Sol 5.6 | El GPT‑5.6 más capaz para código complejo, uso del ordenador, investigación y ciberseguridad. Recomendado para tareas ambiguas, difíciles o de alto valor que necesitan análisis, juicio o acabado extra. | Cuando Terra no basta por complejidad, ambigüedad, riesgo o nivel de acabado. |
| Astra 6 | El modelo más capaz para trabajo complejo de extremo a extremo entre código, aplicaciones e investigación, con razonamiento sostenido y juicio reforzado. | Solo cuando la tarea completa necesita ese nivel de capacidad; no por defecto ni por la maquetación en sí misma. |
Fuente: Modelos de ChatGPT Work y Codex.
La regla que nos importa
La corrección que merece aparecer en esta guía
[CASO REAL] Mientras preparábamos este documento, yo pregunté si convenía hacer una última revisión subiendo el modelo o durante la maquetación. La respuesta automática fue «Astra». Mi corrección fue inmediata:
«Astra no es el modelo que tengo que utilizar para esto. Ahora estás en Terra ligero y puedo subir a Sol para maquetar. ¿Que me quieres gastar token?»
La frase es brusca, pero la lección es perfecta. Que Astra sea el modelo más capaz no demuestra que sea el modelo adecuado. La tarea actual era contrastar y limpiar contenido. Terra ligero podía continuar. Sol podía entrar después si la maquetación o la revisión final exigían más juicio. Recomendar Astra sin justificar el salto era gastar por reflejo.
Cuándo uso Luna
Sí
- Extraer campos de documentos homogéneos.
- Clasificar mensajes con categorías ya definidas.
- Transformar texto a una estructura fija.
- Resumir lotes con una plantilla clara.
- Aplicar cambios repetitivos donde el criterio ya está cerrado.
No como primera opción
- Interpretación legal o regulatoria.
- Arquitectura técnica abierta.
- Documento editorial que todavía no tiene enfoque.
- Decisiones con muchas excepciones o tensiones.
- Un problema que ni siquiera sabemos formular bien.
Cuándo uso Terra
Terra es mi modelo base para el trabajo cotidiano porque equilibra capacidad, velocidad y coste.
Ejemplos
- Preparar la estructura de un documento.
- Limpiar y ordenar contenido ya aprobado.
- Revisar una tabla o un PDF con criterios claros.
- Editar HTML acotado y ejecutar comprobaciones normales.
- Construir una primera versión de una guía con fuentes bien elegidas.
- Analizar un proceso de negocio sin una complejidad extrema.
Cuándo subo a Sol
Señales claras
- Hay ambigüedad real y varias soluciones razonables.
- La tarea conecta muchos sistemas, archivos o restricciones.
- El error tendría impacto legal, económico, operativo o reputacional.
- Necesito una investigación profunda y bien sintetizada.
- La salida final requiere un acabado especialmente exigente.
- Ya existe un intento fallido y hay que entender la causa, no repetirlo.
- La revisión debe encontrar contradicciones entre módulos o fuentes.
Ejemplos reales
[CASO REAL] V.A.I. Para auditar una plataforma real de agentes de voz con problemas de trazabilidad, guardados que podían parecer correctos sin serlo y lógica entre módulos, se eligió Sol con esfuerzo medio. El salto no fue porque el proyecto tuviera muchas pantallas; fue porque había dependencias, severidades y causas raíz que debían conectarse.
[CASO REAL] Numeración 400. El modelo potente no sustituye las fuentes. La complejidad justificaba más análisis, pero la regla de calidad seguía siendo: BOE, normativa aplicable, AEPD cuando correspondiera, fecha de consulta y separación entre hecho, interpretación y duda operativa.
Cuándo no subo a Astra
- Para maquetar un PDF cuyo contenido ya está aprobado.
- Para corregir un título, una tabla o un salto de página.
- Para un comentario de LinkedIn.
- Para convertir una estructura cerrada a otro formato.
- Para una edición técnica acotada que Terra puede ejecutar y verificar.
- Para compensar que he enviado veinte archivos sin explicar cuáles importan.
Parte III. Elegir esfuerzo
Qué significa subir el esfuerzo
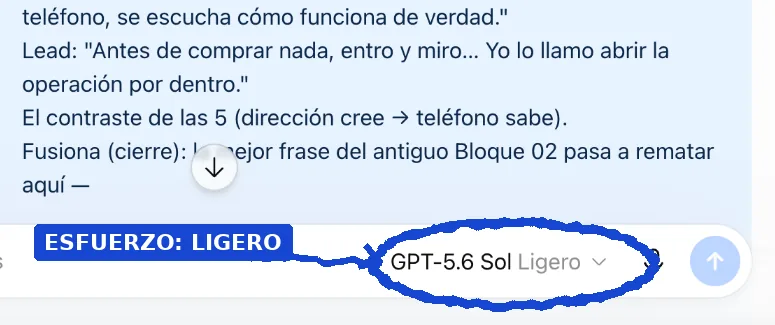
Esta pantalla acredita la combinación usada en ese trabajo: GPT-5.6 Sol con esfuerzo ligero. No demuestra que todas las cuentas tengan las mismas opciones.
| Esfuerzo | Uso oficial resumido | Traducción al trabajo diario |
|---|---|---|
| Light / Low | Tareas rápidas y bien acotadas | «Sé lo que quiero, las fuentes están claras y la salida es sencilla». |
| Medium | Equilibrio entre velocidad y profundidad; más planificación | «Hay varias piezas que ordenar, pero el problema está definido». |
| High / Extra High | Trabajo difícil con varios pasos, fuentes o trade-offs | «Hay que conectar, contrastar y comprobar antes de concluir». |
| Max | Más tiempo de razonamiento para un único problema muy difícil | «La profundidad importa más que la velocidad o el consumo». |
| Ultra | Divide trabajo complejo entre subagentes | «La tarea puede separarse en bloques con sentido y luego integrarse». |
Mi escalera de esfuerzo
Nivel 1. Ligero
Empiezo aquí cuando:
- El objetivo cabe en una frase.
- La salida tiene un formato conocido.
- Hay pocas restricciones.
- Puedo revisar el resultado rápidamente.
Ejemplos: cambiar una fecha, pulir un correo, ordenar una lista, adaptar un texto aprobado, corregir un bloque de HTML localizado.
Nivel 2. Medio
Subo cuando:
- Hay varias fuentes o secciones.
- La estructura todavía debe decidirse.
- Existen dependencias moderadas.
- La primera salida necesita una revisión argumentada.
Ejemplos: crear el índice de esta guía, revisar un dossier, analizar un flujo de captación o preparar un cambio técnico con pruebas.
Nivel 3. Alto o Extra High
Subo cuando:
- Hay normativa, permisos o impacto económico.
- Varias decisiones están en tensión.
- Una conclusión incorrecta puede parecer convincente.
- El problema cruza sistemas, equipos o capas técnicas.
- Necesito una auditoría crítica, no una redacción bonita.
Nivel 4. Max o Ultra
Solo si la tarea lo demuestra. No lo utilizo para sentirme más segura. Lo utilizo si puedo explicar qué gana el trabajo con ese salto.
La pregunta que debe hacerme el asistente
Antes de pedir subir el esfuerzo, quiero una recomendación concreta:
«Puedo continuar con Terra ligero. Te pediré subir a Sol medio solo si encuentro contradicciones entre fuentes, decisiones con impacto o una maquetación que requiera rehacer la arquitectura. Ahora mismo no lo necesito.»
Y si propone subir, debe decir:
- Qué parte de la tarea lo exige.
- Qué riesgo evita.
- Por qué no basta con mejorar contexto o fuentes.
- Si la subida debe durar toda la tarea o solo una fase.
Parte IV. Tokens, créditos y coste real
Tokens y créditos no son lo mismo
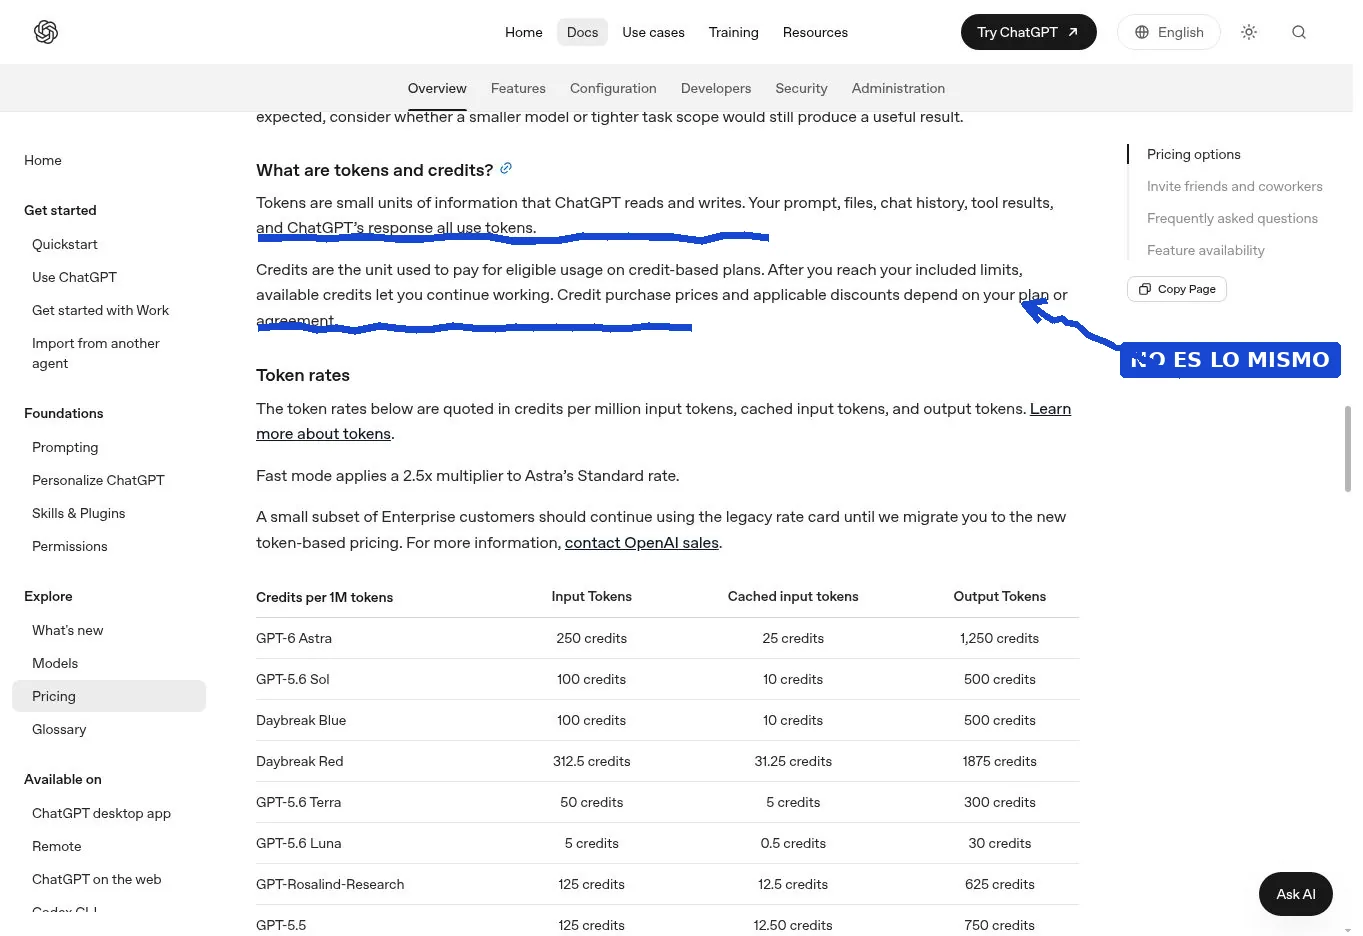
Los tokens son las unidades de información que ChatGPT lee y escribe. Los créditos son la unidad de pago del uso elegible en planes basados en créditos. Captura realizada sobre la documentación oficial de OpenAI consultada el 18.09.2026.
ChatGPT Work y Codex comparten uso, precios, créditos y límites aplicables según el plan. Precios de ChatGPT Work y Codex.
Lo que de verdad dispara el consumo
- El modelo elegido.
- El entorno de ejecución.
- El esfuerzo de razonamiento y la velocidad.
- La complejidad de la tarea.
- Las herramientas utilizadas.
- La frecuencia de ejecución.
- El volumen de entrada y salida.
Los patrones de mayor variación incluyen tareas frecuentes, archivos grandes, búsquedas amplias, múltiples herramientas o aplicaciones, reintentos después de fallos, artefactos grandes y chats de Codex que procesan repositorios o ejecutan comandos. FAQ de administración de ChatGPT Work.
Mis 12 reglas para gastar menos sin trabajar peor
1. Define el entregable antes de hablar del modelo
«Necesito un documento interno de cinco páginas para que ventas responda preguntas sobre X» ahorra más vueltas que «investiga X».
2. Envía solo las fuentes que pueden cambiar la decisión
3. Separa obligatorio, preferible y opcional
Si todo parece crítico, el modelo intentará optimizar veinte cosas a la vez.
4. No uses la conversación como almacén infinito
Cuando un proyecto crece, crea una fuente maestra corta con:
- objetivo;
- decisiones aprobadas;
- fuentes válidas;
- pendientes;
- formato de entrega;
- cosas que no deben tocarse.
5. Divide por fases con puntos de aprobación
Investigación → estructura → redacción → revisión factual → maquetación → QA visual. No pidas todo en una sola orden si vas a cambiar la mitad después.
6. Usa Luna para volumen cerrado
Si el criterio ya existe, no pagues a Sol para repetirlo cien veces.
7. Usa Terra como base
Sube después de observar una necesidad, no antes de empezar.
8. Reserva Sol para la parte difícil
Una tarea puede usar Terra para ordenar materiales, Sol para resolver una contradicción y Terra otra vez para ejecutar cambios mecánicos.
9. No confundas longitud con dificultad
Un documento de 40 páginas con plantilla cerrada puede ser menos difícil que una decisión de una página con consecuencias legales.
10. Limita herramientas y conectores
11. Define la longitud de salida
12. Para después de un fallo y diagnostica
Cinco reintentos casi iguales cuestan más que una pausa para revisar el error, la fuente, el archivo o la restricción que falta.
Parte V. Mi sistema operativo de trabajo
El briefing mínimo de alta densidad
Antes de una tarea sustancial, intento responder a esto:
- Objetivo: qué debe quedar resuelto.
- Audiencia: quién va a usar el resultado.
- Entregable: texto, documento, PDF, tabla, código, imagen o decisión.
- Fuentes de verdad: qué documentos o enlaces mandan.
- Restricciones: qué no debe inventarse, tocarse o publicarse.
- Criterio de aprobación: cómo sabremos que está bien.
- Permisos: solo leer, proponer cambios o ejecutar.
- Parada: dónde debe detenerse para mi revisión.
Plantilla para iniciar un trabajo
Objetivo:
Audiencia:
Resultado que necesito:
Fuentes de verdad:
Lo que no debes inventar:
Lo que no debes tocar:
Formato y longitud:
Criterio de aprobación:
Hasta dónde puedes ejecutar sin preguntarme:

Empieza con el modelo y esfuerzo más bajos que consideres suficientes.
Si propones subir, explica qué parte lo exige y si el cambio es solo para una fase.
Plantilla para investigar sin inventar
Investiga esta pregunta usando fuentes primarias y actuales.

Separa la salida en:
1. Hechos confirmados.
2. Interpretación.
3. Recomendación práctica.
4. Dudas o datos que faltan.
5. Fecha y enlace de cada fuente.

No rellenes huecos. Si dos fuentes chocan, muéstralo.
Plantilla para Codex en solo lectura
Audita este proyecto en solo lectura.
No crees, modifiques, muevas, renombres ni elimines archivos.

Devuelve:
- mapa del problema;
- evidencia con rutas o archivos;
- riesgos;
- propuesta de cambios por prioridad;
- pruebas que ejecutarías después.

Detente antes de implementar.
Plantilla para maquetar sin reabrir el contenido
El contenido de esta versión está aprobado.
Tu tarea es maquetar y hacer QA visual.

No reescribas el fondo salvo que detectes un error factual o una contradicción.
Si ocurre, señálalo y detente en esa sección.

Comprueba:
- jerarquía y legibilidad;
- tablas, saltos y páginas;
- pies, enlaces y fuentes;
- coherencia visual;
- ausencia de texto cortado o elementos fuera de zona segura.
Parte VI. Casos reales desde el barro
Caso 1. De ley a material útil: numeración 400 de Netelip
Problema: una novedad normativa debía convertirse en una fuente interna fiable y, después, en contenido para blog, ayuda y clientes.
Ruta: Work con fuentes oficiales y separación entre hechos, interpretación y decisiones pendientes.
Lo difícil: la ley no respondía automáticamente a cuestiones de precio, migración, tratamiento de cuotas o validación de uso.
Lección: Sol o esfuerzo alto pueden ayudar a conectar piezas, pero no crean la información que Netelip todavía debe decidir.
Aplicación para un CEO: distingue entre lo que ordena la norma y lo que tu empresa debe definir.
Aplicación para un empleado: no conviertas una duda operativa en una afirmación pública.
Caso 2. Auditar antes de tocar: V.A.I. y CEREBRITO-MILI
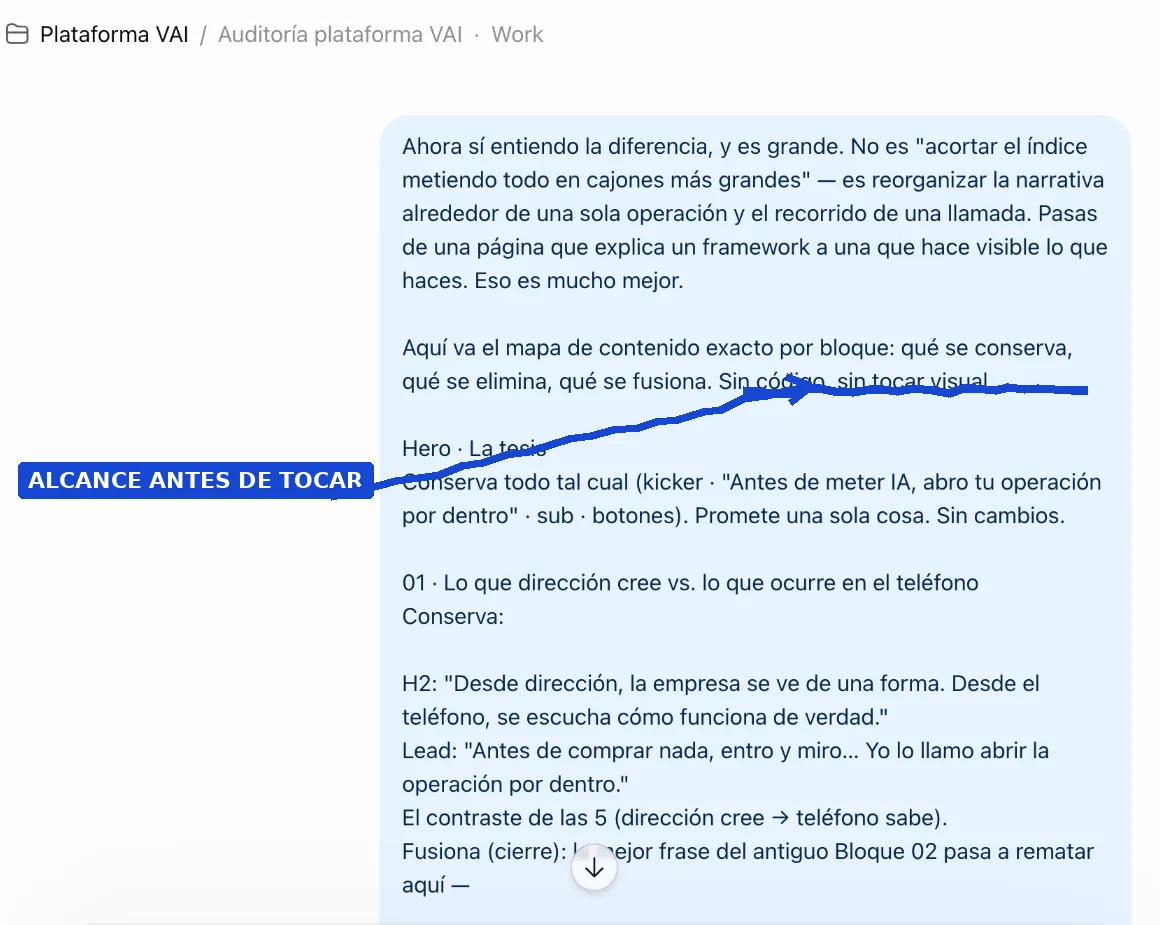
La auditoría de V.A.I. fijó el límite dentro del propio trabajo: mapa de contenido, sin código y sin tocar visual. La orden completa de solo lectura de CEREBRITO se mantiene documentada en el texto.
Problema: revisar una plataforma y su arquitectura sin contaminar la comparación ni modificar el repositorio.
Ruta: Codex, inicialmente en solo lectura. Sol medio cuando aparecieron dependencias funcionales, trazabilidad y lógica entre módulos.
Lo difícil: diferenciar un fallo real de un guardado que parecía correcto y convertir hallazgos en un backlog de causas raíz.
Lección: la mejor optimización no fue bajar el modelo, sino separar auditoría e implementación. Evitó retrabajo y dejó claro qué había ocurrido antes de cambiar nada.
Fragmento recuperado: «Cerebrito de Mili → GPT‑5.6 Sol → Medium».
Caso 3. HTML real: firma de correo
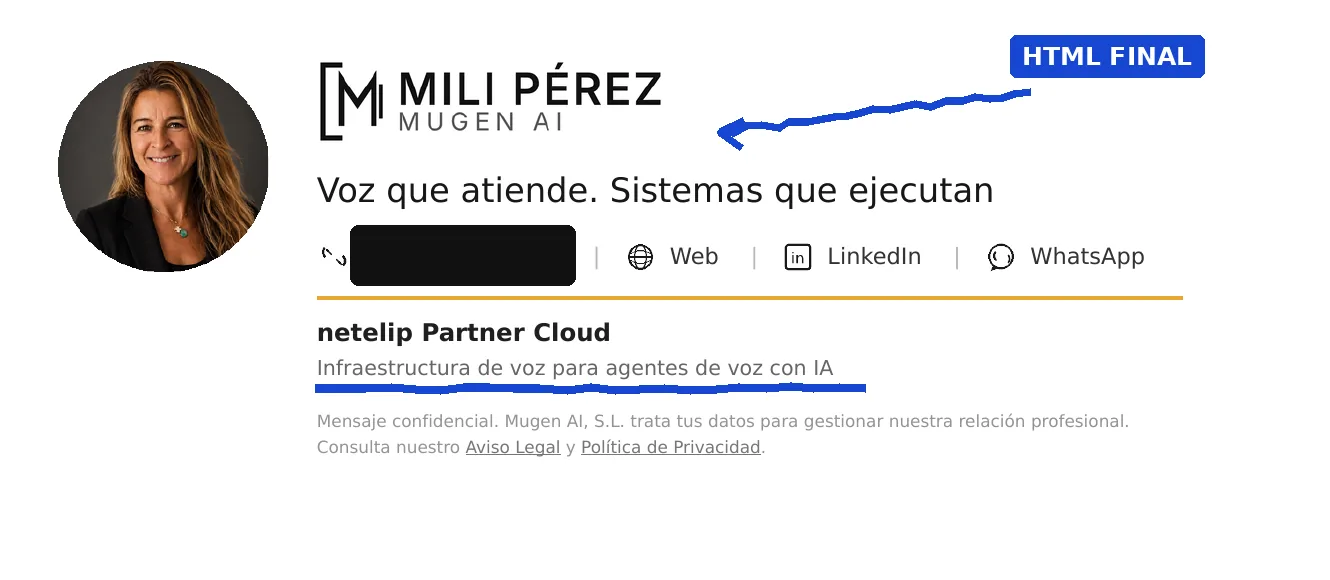
No es un mockup rehecho para la guía. Es el entregable HTML renderizado. El teléfono se ha eliminado de la copia pública y la anotación señala el resultado que debía sobrevivir fuera de la conversación.
Problema: pasar de una decisión visual y de contenido a archivos que debían funcionar.
Ruta: Work para decidir; Codex local + Terra medio para editar, revisar el diff y comprobar.
Escalado: Sol solo si aparecía un problema de renderizado difícil, una dependencia o una revisión final que justificara más profundidad.
Lección: no pagues razonamiento máximo por trabajo mecánico verificable.
Caso 4. Un documento largo no empieza por el PDF
Problema: crear un media kit o dossier editorial sin mezclar contenido, narrativa y maquetación en cada vuelta.
Ruta: Work. Primero fuente maestra; después revisión; por último maquetación y renderizado.
Lección: el PDF es una salida, no la fuente de verdad. Si se corrige el texto dentro del PDF y en otros cinco sitios, aparecen versiones imposibles de controlar.
Decisión actual: este HTML es la fuente maestra maquetada. El PDF se derivará después de aprobar contenido, capturas y comportamiento de impresión; no se corregirá por separado como si fuera otro documento.
Caso 5. Carruseles: una plantilla bonita también puede fracasar
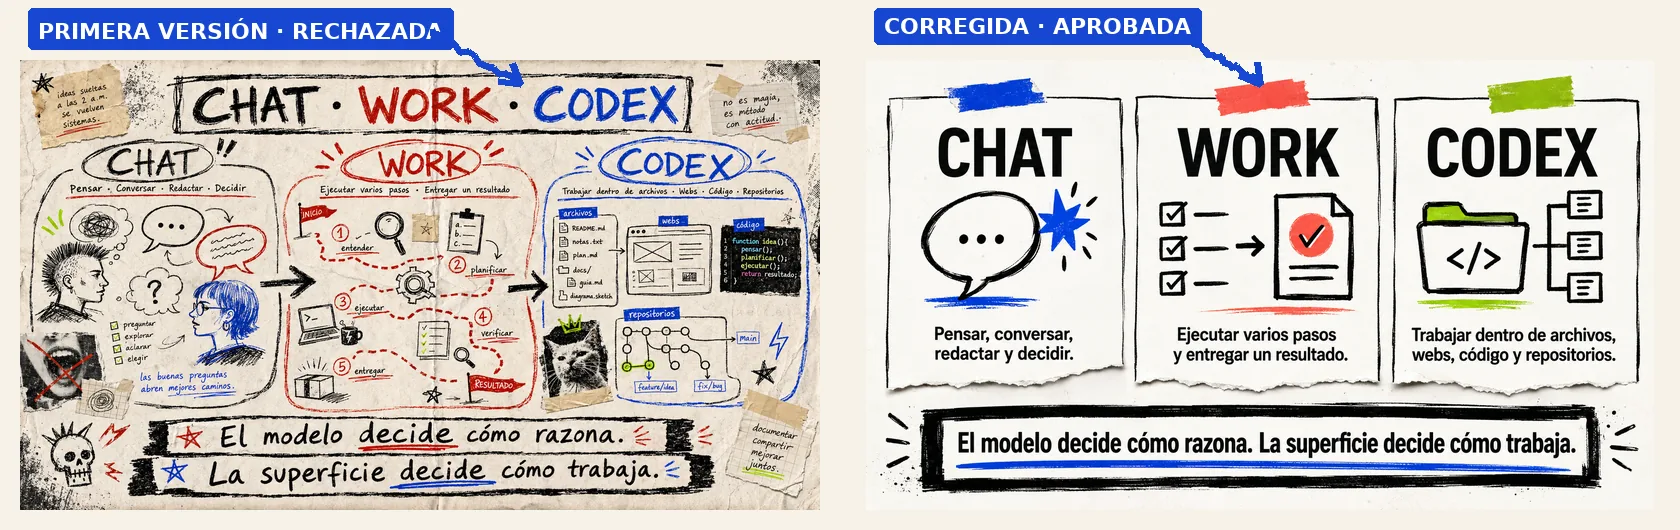
El contenido podía ser correcto y la pieza seguir fallando. La primera composición enterraba la lectura; la segunda ordenó Chat, Work y Codex en tres bloques que se entienden de un vistazo. Las dos versiones pertenecen al proceso real.
Problema: convertir una idea compleja en una pieza que pare el scroll y se entienda sin explicación oral.
Fallo real: un primer storyboard de cinco cajas fue rechazado. El problema no era solo el color: la estructura no contaba la historia como yo la cuento.
Ruta: Work para narrativa y contenido; skill de carruseles para derivar la pieza; revisión visual de cada página.
Lección: subir de modelo no arregla una metáfora equivocada ni una composición que no sostiene el relato.
Regla editorial: golpe → problema → regla → prueba → acción. Una idea principal por página. Si tengo que explicarla por audio, la página no ha terminado.
Caso 6. Zoe y vídeo generado: cada intento cuesta dinero
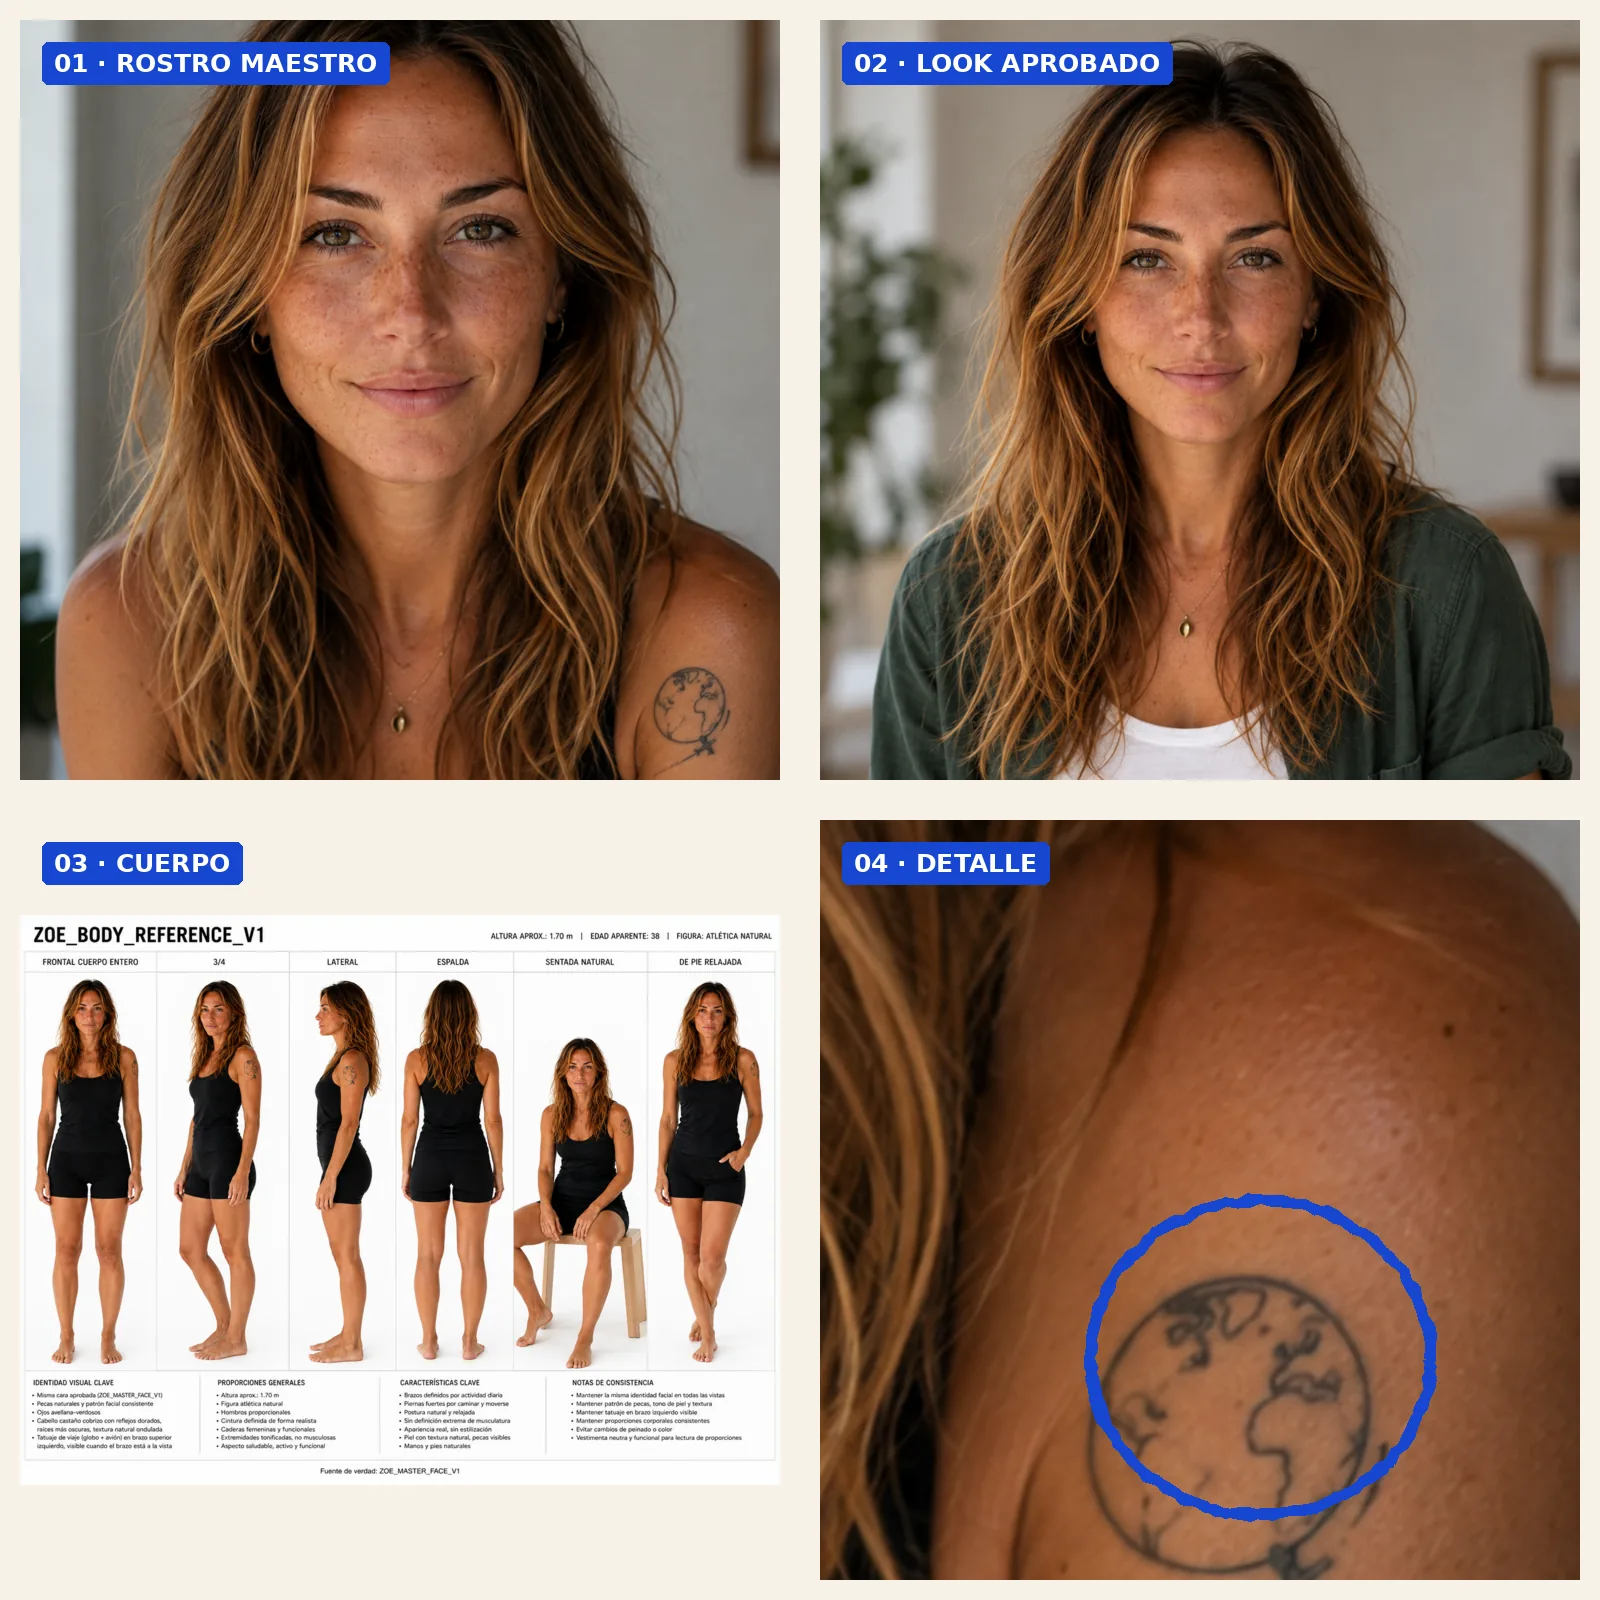
Rostro maestro, look aprobado, cuerpo y detalle del tatuaje. Cuando la identidad debe mantenerse entre herramientas e intentos, estas referencias mandan. Para esta composición no se generó material nuevo.
Problema: mantener identidad, cuerpo, escena y movimiento sin mezclar referencias ni capacidades de modelos distintos.
Ruta: Work para construir fuentes de verdad y plan de pruebas; herramienta de vídeo para ejecutar.
Fallo detectado: se asumió una función de «Elements» para una variante Mini sin confirmación. Se corrigió al verificar que la capacidad documentada correspondía a otra variante.
Lección: cuando cada generación cuesta dinero, el prompt no puede ser una ocurrencia. Hay que cerrar identidad, referencias, encuadre, acción, cámara y criterio de aceptación antes de producir.
Caso 7. Agentes de voz e integraciones
Problema: «crear un agente» parece una tarea, pero en realidad contiene negocio, telefonía, cumplimiento, datos, CRM, operación y errores.
Ruta: Work para diseñar el flujo y Codex para implementar archivos, APIs, webhooks, pruebas o integraciones.
Preguntas mínimas:
- ¿Qué llamadas atiende o realiza?
- ¿Qué puede afirmar y qué no?
- ¿Qué datos guarda y dónde?
- ¿Qué consulta en tiempo real?
- ¿Cuándo deriva a una persona?
- ¿Qué ocurre si falla el CRM, la API o la identificación?
- ¿Quién revisa la trazabilidad?
Lección: el modelo no sustituye la definición del proceso ni los permisos.
Caso 8. Automatización comercial: saber decir «todavía no»
Problema: evaluar una herramienta de automatización de prospección conectada a perfiles personales y CRM.
Ruta: Work para analizar valor, riesgo, credenciales, reputación, trazabilidad, cumplimiento e ICP.
Resultado: no activar todavía porque los perfiles, el CRM y los controles no estaban preparados.
Lección para un CEO: una IA útil no solo acelera. También evita automatizar un desastre.
Parte VII. Matriz para CEOs, constructores y empleados
| Perfil y tarea | Superficie inicial | Modelo inicial | Esfuerzo inicial | Cuándo subir |
|---|---|---|---|---|
| CEO: preparar una decisión con datos conocidos | Work | Terra | Medium | Sol si hay escenarios contradictorios o impacto alto |
| CEO: resumir informes homogéneos cada semana | Work / tarea programada | Luna | Light | Terra si aparecen excepciones o síntesis abierta |
| CEO: analizar regulación o adquisición | Work | Sol | High | Max solo si el problema lo justifica y las fuentes ya están completas |
| Constructor: editar una landing o HTML | Codex | Terra | Medium | Sol si hay arquitectura, fallo difícil o muchas dependencias |
| Constructor: revisión repetible de archivos | Codex | Luna o Terra | Light | Medium si la salida exige interpretación |
| Constructor: auditoría compleja de producto | Codex | Sol | Medium o High | Extra High si cruza módulos y riesgos críticos |
| Empleado: correo, resumen o respuesta corta | Chat | Terra o selector rápido disponible | Light | Medium si hay varias restricciones o sensibilidad |
| Empleado: documento con archivos y fuentes | Work | Terra | Medium | Sol para investigación profunda o acabado de alto valor |
| Equipo de contenido: carrusel desde artículo aprobado | Work | Terra | Medium | Sol si la narrativa no está resuelta, no para exportar el PDF |
| Equipo legal/compliance: guía pública | Work | Sol | High | Revisión humana y fuente primaria; el modelo no reemplaza aprobación |
Esta tabla es un punto de partida, no un tarifario universal. [VARIABLE] La disponibilidad exacta de modelos, esfuerzos, velocidad y funciones depende de plan, cuenta y despliegue.
Parte VIII. Errores que más créditos queman
1. Elegir primero el modelo
Solución: define resultado, riesgo y entorno.
2. Usar Astra porque es «el mejor»
Solución: explica qué parte necesita capacidad de extremo a extremo. Si no puedes, empieza más abajo.
3. Subir esfuerzo cuando falta contexto
Solución: busca la fuente, decisión o restricción que falta.
4. Mandar todos los archivos «por si acaso»
Solución: identifica fuente de verdad, anexos y material descartado.
5. Pedir investigación y maquetación en el mismo salto
Solución: aprueba el contenido antes del diseño final.
6. Reintentar sin diagnosticar
Solución: conserva el error, identifica la causa y cambia una variable cada vez.
7. Confundir una respuesta segura con una respuesta verificada
Solución: exige enlace, fecha y evidencia para hechos actuales o sensibles.
8. Usar una conversación enorme como memoria
Solución: crea un handoff corto de decisiones aprobadas.
9. No definir permisos
Solución: di «solo leer», «proponer» o «ejecutar hasta este punto».
10. Dar por bueno un archivo porque se generó
Solución: renderiza documentos, reproduce vídeos completos y ejecuta pruebas de código.
Parte IX. La skill operativa que debe salir de esta guía
La skill no debe contener toda esta guía. Debe convertirla en decisiones rápidas.
Comportamiento obligatorio
- Clasificar la tarea por entregable y riesgo.
- Recomendar Chat, Work o Codex con una frase de justificación.
- Elegir Luna, Terra, Sol o Astra desde la opción menos costosa razonable.
- Elegir esfuerzo inicial.
- Identificar fuentes y archivos mínimos.
- Definir validación y punto de parada.
- Pedir subida de modelo o esfuerzo solo con una razón concreta.
- Separar dato oficial, criterio de Mili e inferencia.
- No volver a afirmar que Terra, Luna y Sol carecen de definición pública.
- No volver a recomendar Astra por reflejo.
Respuesta corta esperada de la skill
Ruta: Work.
Modelo: Terra.
Esfuerzo: Light.
Motivo: estamos contrastando y ordenando contenido con fuentes claras.
Subiría a Sol Medium solo para resolver contradicciones difíciles o para una revisión/maquetación final que exija más juicio.
No usaría Astra en esta fase.
Validación: citas oficiales, registro de cambios y aprobación del texto antes del PDF.
Parte X. Protocolo editorial para publicar esta guía
Lo que sí puede salir
- Decisiones de entorno y modelo.
- Errores y correcciones que enseñen algo.
- Capturas o fragmentos donde no aparezcan datos sensibles.
- Casos de producto explicados con límites y fuentes.
- Prompts reutilizables.
- Resultados y fallos con contexto suficiente.
Lo que debe anonimizarse o excluirse
- Credenciales, claves, números privados e infraestructura detallada.
- Conversaciones internas sobre empleados.
- Datos de clientes y cuentas.
- Condiciones comerciales no públicas.
- Documentos con avisos de confidencialidad.
- Opiniones personales que no sean necesarias para enseñar el método.
Cómo citar nuestras conversaciones
Cada fragmento debe indicar:
- fecha;
- proyecto;
- contexto mínimo;
- si es texto literal o paráfrasis;
- qué aprendizaje demuestra.
Una bronca sin contexto es entretenimiento. Una corrección que explica por qué cambia una decisión sí es documentación.
Checklist final de una tarea
Antes
- ¿Sé qué debe quedar terminado?
- ¿He elegido superficie antes que modelo?
- ¿He incluido solo las fuentes necesarias?
- ¿He indicado qué no se puede inventar o tocar?
- ¿He definido revisión y punto de parada?
Durante
- ¿La dificultad real justifica el modelo y el esfuerzo actuales?
- ¿Hay una contradicción o solo falta información?
- ¿Estoy repitiendo intentos sin diagnosticar?
- ¿Debo dividir la tarea en fases?
Después
- ¿Los hechos actuales tienen fuente y fecha?
- ¿Las inferencias están marcadas?
- ¿El archivo se ha inspeccionado visualmente?
- ¿El código se ha comprobado con pruebas o verificaciones?
- ¿El resultado suena a Mili y sirve a su audiencia?
- ¿Quedan pendientes claramente registrados?
Registro de afirmaciones y fuentes oficiales
| Afirmación utilizada | Fuente oficial | Estado |
|---|---|---|
| Chat sirve para respuestas, explicaciones, ideas y borradores cortos; Work para tareas con resultado claro y revisable | Get started with ChatGPT Work | Verificada 18/09/2026 |
| Work puede usar archivos, plugins y herramientas; local y cloud tienen usos distintos | Get started with ChatGPT Work | Verificada 18/09/2026 |
| Luna, Terra, Sol y Astra tienen recomendaciones públicas diferenciadas | Models | Verificada 18/09/2026 |
| Mayor esfuerzo puede mejorar tareas complejas, pero tarda más y usa más tokens | Models | Verificada 18/09/2026 |
| Usar el esfuerzo más bajo que produzca el resultado necesario | Models | Verificada 18/09/2026 |
| Max profundiza en una tarea; Ultra usa subagentes; la mayoría no necesita ambos | Models | Verificada 18/09/2026 |
| Tokens miden entrada y salida; créditos pagan uso elegible según el acuerdo | ChatGPT Work: usage and cost | Verificada 18/09/2026 |
| Work y Codex comparten precios, créditos y límites aplicables | Pricing | Verificada 18/09/2026 |
| Acotar prompts, fuentes, salida, AGENTS.md y MCP ayuda a alargar límites | Pricing | Verificada 18/09/2026 |
| Archivos grandes, recuperación amplia, herramientas múltiples y reintentos elevan la variación de consumo | Work admin FAQ | Verificada 18/09/2026 |
| Codex local y cloud tienen entornos y controles distintos | Work admin FAQ | Verificada 18/09/2026 |
Límites de esta versión
- Los nombres, modelos, precios y opciones de esfuerzo pueden cambiar. Esta guía necesita fecha de revisión visible.
- No se publicarán cifras de consumo por tarea como si fueran universales: dependen de plan, modelo, contexto, herramientas y ejecución.
- Las capturas incluidas han pasado una revisión específica de privacidad. Cualquier conversación o captura que se incorpore después deberá superar el mismo control antes de publicarse.
- Las recomendaciones de Mili no son promesas de OpenAI.
- Esta versión todavía debe pasar por revisión de voz, revisión factual final y aprobación editorial antes de maquetarse.
Mi regla final
El objetivo es terminar bien el trabajo usando solo la potencia necesaria.
Luna cuando la tarea está cerrada. Terra para el día a día. Sol cuando el problema lo merece. Astra solo cuando puedo explicar por qué el trabajo completo necesita esa capacidad.
Chat para pensar y responder. Work para producir. Codex para actuar sobre archivos, código y entornos verificables.
Y antes de subir el modelo, siempre la misma pregunta:
¿Necesito más inteligencia, o necesito explicar mejor el problema?